
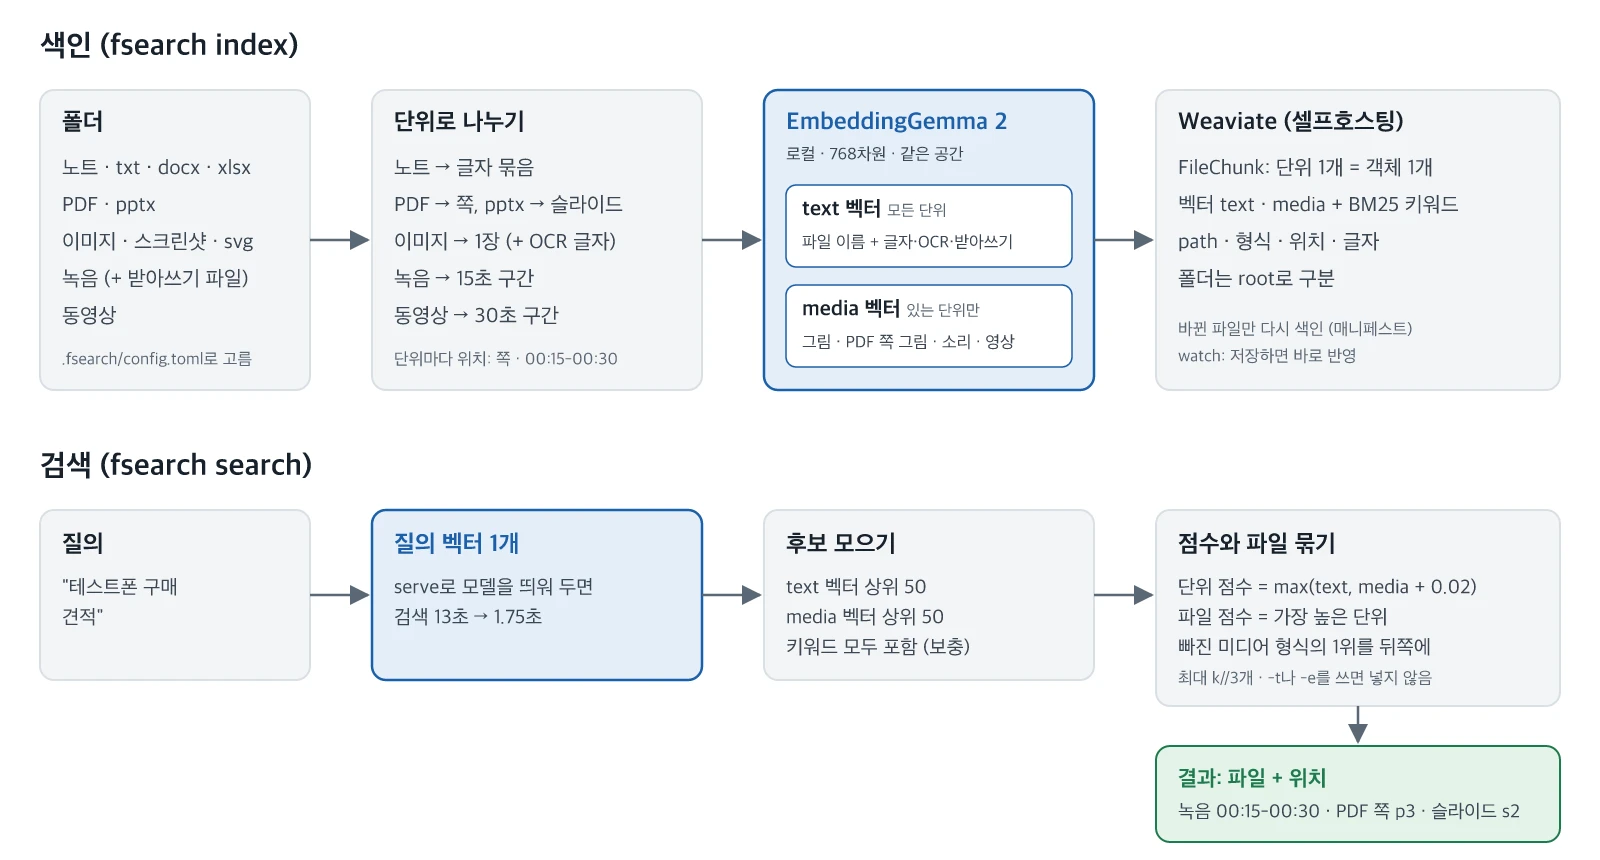
EmbeddingGemma 2는 텍스트·이미지·오디오·동영상을 한 벡터 공간에 넣는 공개 멀티모달 임베딩 모델입니다. 이 모델과 직접 운영하는 Weaviate로 이름에 내용이 없는 스크린샷, 녹음, 스캔 PDF까지 "기억나는 내용"으로 찾는 로컬 파일 검색 CLI fsearch를 만들었습니다.
2026년 10월에 모델 불러오기부터 Weaviate 컬렉션 설계, 두 벡터로 순위 매기기, 시연 폴더 검색, 텍스트 임베딩+OCR과의 비교, 실제 노트 폴더(파일 4,497개) 측정까지 직접 해 봤습니다. 그 화면과 숫자를 그대로 정리했습니다.
핵심 요약
- 모델: 텍스트·이미지·오디오·동영상을 모두 768차원 벡터 하나로 만듭니다. 형식이 달라도 코사인 유사도 하나로 비교할 수 있습니다.
- 잘 찾은 것: 스크린샷은 그림 벡터와 OCR 글자를 함께 쓸 때 가장 잘 찾았습니다(스크린샷 질의 20개 중 1위 16개, 3위 안 20개). 글자가 없는 사진, 이름이
scan-0012.pdf인 견적서도 1위로 찾았습니다.- 차이가 작았던 것: 글자가 잘 뽑히는 문서는 기존 텍스트 임베딩 모델과 결과가 거의 같았습니다. 녹음은 받아쓰기가 있을 때 훨씬 잘 찾았습니다.
- 큰 폴더: 파일 4,497개에서 질의 42개 중 10위 안이 35개였고 이미지·동영상 순위 보정을 넣은 뒤 39개가 되었습니다.
- 비용: 색인이 느립니다. 첫 색인은 약 104분이 걸렸고 이후에는 바뀐 파일만 색인합니다.
이 글의 대상 독자와 기준일
- 임베딩과 벡터 DB의 기본 개념은 알고 이미지·녹음이 섞인 폴더를 검색하고 싶은 개발자
- 멀티모달 임베딩이 텍스트 임베딩+OCR보다 실제로 나은지 숫자로 보고 싶은 분
모델 정보는 2026-10-13에 확인한 모델 카드 기준입니다. 측정은 표본이 작아서(비교 시험의 이미지 5장, 녹음 1개) 숫자는 방향을 보는 정도로 읽어 주세요.
EmbeddingGemma 2란?
EmbeddingGemma 2는 텍스트(코드 포함), 이미지, 동영상, 오디오를 따로 넣든 섞어 넣든 768차원 벡터 하나로 바꾸는 공개 임베딩 모델입니다. 모든 형식이 같은 공간에 놓이므로 "회의 녹음"이라는 글자 검색어로 녹음 소리에서 만든 벡터를 바로 찾을 수 있습니다. 라이선스는 Apache 2.0입니다.
| 항목 | 내용 |
|---|---|
| 입력 | 텍스트(코드 포함), 이미지, 동영상, 오디오, 그리고 이들을 섞은 것 |
| 출력 | 768차원 벡터 하나. 모든 형식이 같은 공간에 놓임 |
| 크기 | 전체 740M. 텍스트 270M + 비전 인코더 170M + 오디오 인코더 300M |
| 필요한 인코더만 불러오기 | 텍스트만 270M, 텍스트+이미지 440M, 텍스트+오디오 570M |
| 차원 줄이기 (MRL) | 768 → 512 / 256 / 128 |
| 입력 한도 | 벡터 하나를 만드는 입력 한 번에 8,192토큰 |
| 언어 | 100개 이상 |
| 라이선스 | Apache 2.0 |
입력 한도와 MRL은 조금 더 풀어 보겠습니다.
- 입력 한도. 모델은 글자든 그림이든 소리든 토큰으로 바꿔 읽습니다. 이미지는 1장에 280토큰, 동영상은 1프레임에 140토큰, 오디오는 1초에 25토큰입니다. 한 형식만 넣으면 한 번에 이미지 약 29장, 동영상 약 58프레임, 오디오 약 327초까지 들어갑니다. 글과 그림을 섞어 넣으면 이 8,192토큰을 나눠 씁니다. fsearch가 긴 녹음과 동영상을 구간으로 잘라 넣는 데는 이 한도도 한몫합니다.
- MRL(Matryoshka Representation Learning). 다시 학습하지 않고 768차원 벡터의 앞부분만 잘라 써도 되도록 학습했다는 뜻입니다. 자른 뒤에는 다시 L2 정규화해야 하고 질의와 문서의 차원을 맞춰야 합니다. 모델 카드의 점수로 보면 256차원에서 다국어 텍스트 벤치마크(MTEB 평균)는 61.36 → 60.41, 멀티모달(MMEB)은 59.01 → 56.24로 조금 떨어집니다. 128차원에서는 멀티모달이 45.65로 크게 떨어집니다. fsearch는 768차원을 그대로 씁니다.
왜 멀티모달 임베딩으로 파일을 찾나
작업 폴더에는 글자로 된 노트만 있지 않습니다. Screenshot 2026-09-18 at 10.42.13.png 같은 스크린샷, 새로운 녹음 3.m4a 같은 녹음, 스캐너가 붙인 scan-0012.pdf, 휴대폰에서 옮긴 IMG_0412.png 사진이 섞여 있습니다. 이런 파일은 이름에 내용이 없어서 파일 이름 검색이나 grep으로는 찾기 어렵습니다.
"지난주 로그인 토큰 만료 오류 화면", "테스트폰 견적서"처럼 기억나는 내용으로 찾고 싶었습니다. 텍스트 임베딩 모델로 이 일을 하려면 이미지는 OCR, 녹음은 STT로 먼저 글자를 만들어야 합니다. 글자가 거의 없는 사진은 OCR로도 찾기 어렵습니다. 그래서 이미지와 소리를 그대로 임베딩하는 멀티모달 모델을 써 보기로 했습니다.
fsearch 만드는 순서
- EmbeddingGemma 2를 불러와 텍스트·이미지·오디오 벡터 만들기
- 폴더를 색인하고 찾는 CLI 명령 정하기
- 파일을 단위로 나눠 Weaviate에 벡터 두 개씩 저장하기
- text·media 벡터로 찾고 순위 매기기
- 시연 폴더에서 사진·스캔 PDF·녹음 검색해 보기
멀티모달 임베딩이 실제로 나은지는 텍스트 임베딩 + OCR 비교에서, 큰 폴더에서 생긴 문제와 보정은 실제 노트 폴더 측정에서 볼 수 있습니다.
이 글의 환경
아래 표는 제가 쓴 환경입니다. 최소 사양은 따로 재지 않았습니다.
| 항목 | 이 글의 환경 |
|---|---|
| 컴퓨터 | Apple Silicon Mac, RAM 32GB |
| Python | 3.12, uv |
| 주요 패키지 | sentence-transformers 6.1.0, transformers 5.19.0, torch 2.14.1 |
| 모델 | google/embeddinggemma-2, 처음 약 1.5GB 내려받음. Hugging Face 로그인 없이 받아짐 |
| 미디어 처리 | ffmpeg(오디오·동영상), torchcodec(동영상), resvg-py(svg) |
| OCR | macOS Vision(pyobjc). 불러오지 못하면 OCR 없이 동작 |
| Weaviate | 1.39.6, 셀프호스팅. 한국어 키워드 검색을 위해 ENABLE_TOKENIZER_KAGOME_KR=true |
이 글의 숫자는 서로 다른 세 시험에서 나왔습니다. 폴더도 질의도 다르니 숫자를 서로 바로 비교하지는 마세요.
| 시험 | 폴더 | 질의 | 나오는 곳 |
|---|---|---|---|
| 시연 | 이 글을 위해 만든 작은 폴더, 파일 11개 | 화면으로 보여 준 5개 | 5장 |
| 방식 비교 | 개인 자료 폴더, 248단위(스크린샷 5장, 녹음 1개 포함) | 99개 | 6장 |
| 큰 폴더 | 실제 노트 폴더의 사본, 파일 4,497개(23,163단위) | 42개 | 7장 |
1. EmbeddingGemma 2 불러오기와 임베딩 만들기
1-1. 모델 불러오기
model = SentenceTransformer("google/embeddinggemma-2", device="mps",
                            model_kwargs={"torch_dtype": torch.float32})

# 색인할 때: 찾을 대상을 미리 벡터로 만들어 저장해 둔다
model.encode("title: 회의록 | text: 다음 주 일정 논의")          # 문서
model.encode(Image.open(path).convert("RGB"))                 # 이미지
model.encode({"array": samples, "sampling_rate": 16000})      # 오디오 (모노 16kHz)

# 검색할 때: 검색어만 그 자리에서 벡터로 만든다
model.encode("회의 녹음", prompt_name="SearchQuery")           # 검색 질의
네 줄 모두 768차원 벡터 하나를 돌려줍니다. 문서·이미지·오디오 벡터는 색인할 때 한 번 만들어 벡터 DB에 넣어 두고 검색할 때는 검색어 벡터만 새로 만듭니다. 그다음 검색어 벡터와 코사인 유사도가 높은 순서로 저장해 둔 벡터를 꺼냅니다.
유사도 계산은 모델이 하지 않습니다. 벡터 DB(fsearch에서는 Weaviate)가 색인을 써서 가까운 벡터를 빠르게 찾습니다.
1-2. 직접 돌려 보며 확인한 것
- 텍스트·이미지·오디오 모두 768차원, 정규화된 벡터가 나옵니다. 유사도는 코사인 하나로 형식에 상관없이 계산할 수 있습니다.
- 텍스트에는 용도별 접두어를 붙입니다. 질의는
task: search result | query:, 문서는title: {제목} | text: {본문}입니다. 이미지·오디오에는 붙이지 않습니다. - 처음 내려받기는 약 1.5GB였고 내려받은 뒤 모델을 불러오는 데 약 7초가 걸렸습니다.
float16으로 불러오지 마세요
모델 카드에 따르면
float16으로 돌리면 오류 없이 NaN이나 품질이 떨어진 벡터가 나옵니다. 그래서float32로 불러왔습니다.
2. fsearch 명령 구성
fsearch는 파이썬 CLI입니다. 임베딩은 이 컴퓨터에서 계산합니다. 추출한 글자와 벡터, 키워드 색인은 직접 운영하는 Weaviate 서버(셀프호스팅)에 둡니다. fsearch가 파일 내용을 외부 서비스로 보내지는 않습니다.
| 명령 | 하는 일 |
|---|---|
fsearch init <폴더> | 폴더 설정 파일(.fsearch/config.toml)을 만듭니다. 색인할 형식과 뺄 경로를 고릅니다 |
fsearch index <폴더> | 새 파일과 바뀐 파일만 색인합니다 |
fsearch search "<질의>" | 파일과 맞은 위치(쪽, 슬라이드, 녹음 구간)를 보여 줍니다. -f <폴더>를 주면 그 폴더에서 색인한 것만 찾습니다(색인한 최상위 폴더 기준이라 하위 폴더를 주면 결과가 없습니다). -k는 보여 줄 파일 수(기본 10)이고 키워드 일치 파일이 그 뒤에 최대 3개 더 붙을 수 있습니다 |
fsearch serve | 모델을 메모리에 띄워 둡니다. 작은 시험 폴더에서 검색 한 번이 13초에서 1.75초로 줄었습니다 |
fsearch watch <폴더> | 파일 변경이 2초쯤 멈추면 바뀐 파일을 색인합니다 |
fsearch list / remove | 색인한 폴더를 보거나, 폴더 하나의 색인을 통째로 지웁니다. 폴더 설정 파일(.fsearch/config.toml)도 함께 지웁니다 |
검색을 여러 번 할 거라면
fsearch serve부터 띄워 두세요. 검색할 때마다 모델을 다시 불러오지 않아도 됩니다.
3. Weaviate에 단위와 벡터 저장하기
3-1. 파일을 단위로 나누기
파일 하나를 통째로 벡터 하나로 만들지 않고 단위로 나눕니다. 그래야 "몇 쪽", "몇 분 몇 초"를 알려 줄 수 있습니다.
| 파일 형식 | 단위 |
|---|---|
쪽. 세로로 긴 쪽은 여러 조각으로 나눔(p1#2처럼 표시) | |
| pptx | 슬라이드. 안의 그림은 따로 |
| 녹음 | 15초 구간. 받아쓰기가 있으면 받아쓰기 문장을 약 15초씩 묶음 |
| 동영상 | 30초 구간 |
3-2. 단위 하나에 벡터 두 개 (named vector)
단위 하나가 Weaviate 객체 하나이고 객체에 Weaviate의 이름 있는 벡터(named vector)를 붙입니다.
text벡터: 모든 단위에 있습니다. 파일 이름 + 글자(본문, OCR 글자, 받아쓰기)를 임베딩합니다.media벡터: 그림·소리·영상이 있는 단위에만 있습니다. 이미지, PDF 쪽을 그린 그림, pptx 안의 그림, 녹음 구간, 동영상 구간입니다. md 노트 같은 글자 단위에는 없습니다.
단위마다 객체에 들어가는 것은 이렇습니다.
| 단위 예시 | 저장하는 글자 | text 벡터 | media 벡터 |
|---|---|---|---|
| md 노트의 글자 묶음 | 본문 | 파일 이름 + 본문 | 없음 |
| 글자가 있는 스크린샷 1장 | OCR 글자 | 파일 이름 + OCR 글자 | 그림 |
| 녹음 구간, 받아쓰기 있음 | 그 구간의 받아쓰기 문장 | 파일 이름 + 받아쓰기 | 그 구간의 소리 |
| 녹음 15초 구간, 받아쓰기 없음 | 없음 | 파일 이름만 | 그 구간의 소리 |
3-3. Weaviate 컬렉션 만들기
벡터는 fsearch가 직접 계산해 넣습니다. 그래서 Weaviate에는 self_provided로 정의합니다(속성은 일부만 적었습니다).
def _vector(name):
    return Configure.Vectors.self_provided(
        name=name,
        vector_index_config=Configure.VectorIndex.hnsw(distance_metric=VectorDistances.COSINE),
    )

client.collections.create(
    "FileChunk",
    vector_config=[_vector("text"), _vector("media")],   # 객체 하나에 벡터 두 개
    properties=[
        Property(name="path", data_type=DataType.TEXT, tokenization=Tokenization.FIELD),
        Property(name="content", data_type=DataType.TEXT, tokenization=Tokenization.KAGOME_KR),
        # root, file_type, unit, start_sec, end_sec ...
    ],
)
4. 두 벡터로 검색하고 순위 매기기
4-1. 벡터 점수 계산
검색할 때는 질문을 임베딩한 벡터 하나로 text와 media를 각각 찾고(각 상위 50개), 둘 중 한쪽에만 걸려도 후보가 됩니다. 단위 점수는 둘을 더하지 않고 큰 값을 씁니다. 이미지·동영상이 노트에 밀리지 않게 media 유사도에는 0.02를 더합니다.
MEDIA_BIAS = 0.02
qv = model.encode("노트북 위에서 자는 고양이", prompt_name="SearchQuery").tolist()  # 질문 임베딩

best, path_of = {}, {}   # 단위 id → 점수, 단위 id → 파일 경로
for name, bias in [("text", 0.0), ("media", MEDIA_BIAS)]:
    res = col.query.near_vector(
        near_vector=qv, target_vector=name, limit=50,        # 벡터마다 상위 50단위
        # filters=Filter.by_property("root").equal(root),    # -f처럼 폴더로 좁힐 때
        return_properties=["path", "unit"],
        return_metadata=MetadataQuery(distance=True),
    )
    for o in res.objects:
        sim = 1 - o.metadata.distance + bias                 # 코사인 거리 → 유사도
        best[o.uuid] = max(best.get(o.uuid, -1.0), sim)      # 단위 점수: 두 벡터 중 큰 값
        path_of[o.uuid] = o.properties["path"]

files = {}
for uid, score in best.items():
    path = path_of[uid]
    files[path] = max(files.get(path, -1.0), score)          # 파일 점수: 가장 높은 단위 점수
files에는 후보(벡터마다 상위 50단위)에 든 파일만, 그 파일에서 가장 잘 맞은 단위의 점수로 들어갑니다. 이것을 점수 순으로 정렬한 것이 기본 순위입니다.
위 코드는 fsearch의 벡터 점수 계산과 파일별 최고점 집계만 줄인 예시입니다. 실제 검색에는 형식별 후보 조회, 형식별 1위 넣기, 키워드 일치 덧붙이기도 적용됩니다.
형식이 달라도 같은 공간의 코사인이라 한 줄로 순위를 매길 수 있습니다. 이 모델을 쓴 것도 그래서입니다. 다만 그대로 섞으면 큰 폴더에서 이미지·동영상이 밀려서 7장의 작은 보정이 필요했습니다.
4-2. 키워드 검색(BM25)은 따로 쓴다
키워드 검색(BM25)은 순위 점수에 섞지 않았습니다. 섞으면 글자가 없는 이미지가 늘 불리해지기 때문입니다. 한국어 단어 나누기에는 Weaviate의 kagome_kr 형태소 분석기를 씁니다. BM25를 쓰는 곳은 두 가지뿐입니다.
- 키워드 일치 덧붙이기. 기본 검색은 벡터 점수로만 순위를 정합니다. 그다음 BM25를 따로 돌려 파일 이름과 본문(OCR 글자·받아쓰기 포함)에 질의의 단어가 모두 들어 있는 단위를 찾고 위 순위에 없던 파일을 결과 끝에 "키워드 일치"로 최대 3개 덧붙입니다. 앞 순위는 바뀌지 않습니다.
- 정확 일치 모드(
-e). 오류 코드나 버전 번호처럼 글자로 찾을 때는 순서를 바꿔 질의의 단어가 모두 들어 있는 단위만 먼저 고르고 그 안에서 벡터 유사도로 정렬합니다. 문장을 한 글자도 틀리지 않고 이어서 찾는 방식은 아니고 형태소 분석기로 나눈 단어가 모두 들어 있는지를 봅니다.
5. 시연 폴더로 직접 검색해 보기
5-1. 시연 폴더 구성과 색인
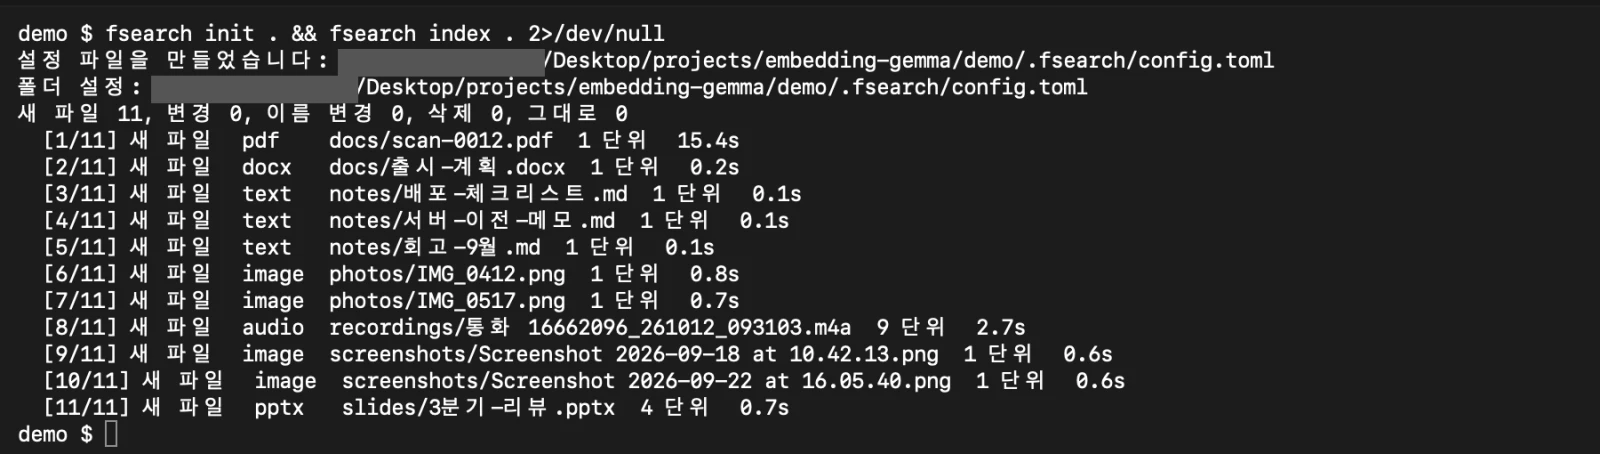
이 글을 위해 작은 폴더를 만들었습니다. 노트 3개, 스크린샷 2장, 휴대폰 사진처럼 만든 생성 이미지 2장, docx, pptx, 그림으로만 된 스캔 PDF는 공개용으로 새로 만든 것입니다. 녹음 1개는 제 개인 자료 폴더에서 복사해 왔습니다. 고객센터 자동 안내(ARS) 통화 녹음(약 2분)과 그 받아쓰기입니다. 스크린샷·사진·스캔 PDF·녹음의 이름은 실제 폴더처럼 내용과 상관없는 이름입니다.
받아쓰기는 제 Obsidian 볼트에 녹음이 들어오면 별도의 자동화가 Mistral API의 Voxtral로 만들어 녹음 파일 옆에 받아쓰기 파일(<녹음 이름>.voxtral.json)로 둔 것입니다. 그래서 fsearch는 음성 인식을 다시 돌리지 않고 이름이 짝인 받아쓰기 파일을 찾아 씁니다. 처음에는 받아쓰기 없이 녹음만 넣었습니다.
fsearch init . && fsearch index .
5-2. 사진·스캔 PDF·화이트보드 찾기
fsearch search "노트북 위에서 자는 고양이" -f . -k 3
fsearch search "테스트폰 구매 견적" -f . -k 3
fsearch search "포스트잇을 붙인 화이트보드" -f . -k 3

결과 읽는 법
- 파일 아래 줄의 첫 칸은 위치입니다.
p1은 1쪽,00:30-00:45는 녹음 구간,c1은 첫 번째 글자 묶음,-는 이미지처럼 위치가 하나뿐인 단위입니다.text+media는 그 단위가 두 벡터 목록 모두에서 후보로 나왔다는 표시입니다. 점수는 두 벡터 점수 중 큰 값입니다.
- 글자가 하나도 없는 고양이 사진이 0.7633으로 1위입니다. 사진 아래
(는 OCR이 사진에서 읽어 낸 글자 조각입니다. - 이름이
scan-0012.pdf인 견적서가 1위입니다. 쪽 그림의 OCR 글자가 미리보기로 나옵니다. 3위 스크린샷의 "(형식별 1위)"는 결과에 이미지가 없어서 이미지 1위를 넣은 것입니다. - 화이트보드 사진도 1위입니다.
- 세 질의 모두 녹음과 상관이 없는데 받아쓰기 없는 녹음이 0.63~0.68로 2위에 올라왔습니다. 소리 벡터만으로는 이 녹음을 상관없는 질의에서 걸러 내지 못했습니다.
5-3. 받아쓰기 없이 통화 녹음 찾기
fsearch search "이 통화 녹음되고 있어?" -f . -k 3
fsearch search "수선이나 수리 맡기려면 몇 번 눌러?" -f . -k 3

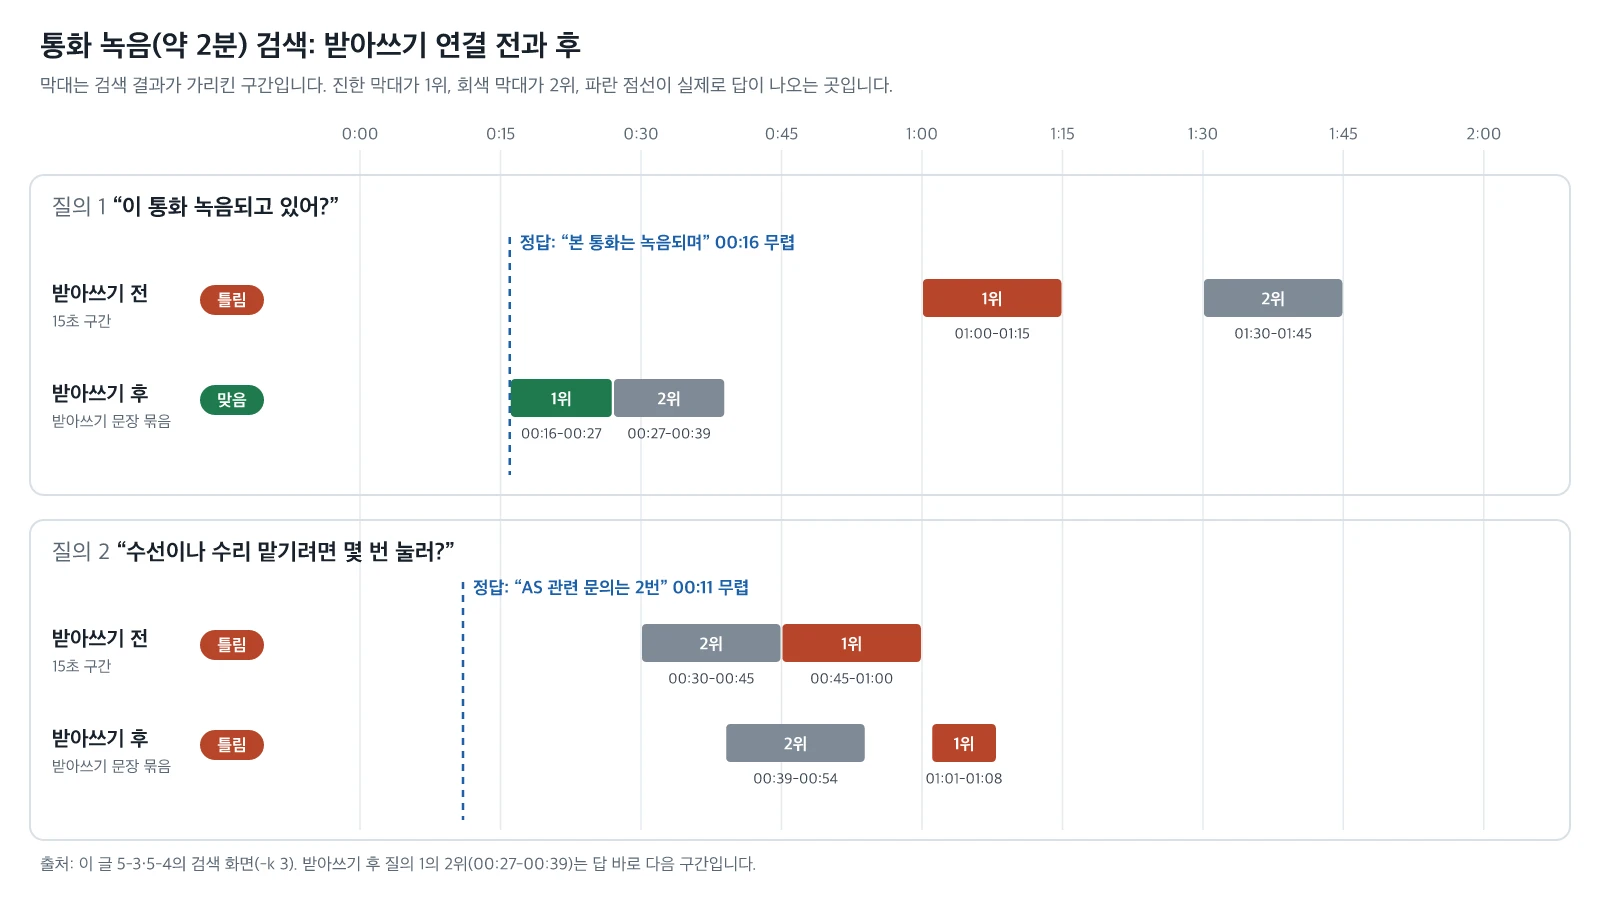
폴더에 녹음이 하나뿐이라 파일은 둘 다 1위입니다. 그런데 위치가 맞지 않았습니다. "녹음되고 있어?"의 답은 안내 앞부분(00:16 무렵)에 있는데 01:00-01:15와 01:30-01:45를 가리켰습니다. 위치 옆에 보여 줄 글자도 없습니다.
5-4. 받아쓰기를 연결하고 다시 찾기
받아쓰기 파일을 녹음 옆에 두고 다시 색인했습니다.
demo $ fsearch index .
새 파일 0, 변경 1, 이름 변경 0, 삭제 0, 그대로 10
  [1/1] 변경  audio  recordings/통화 16662096_261012_093103.m4a  7 단위 (받아쓰기 연결)  11.7s
그리고 같은 질의를 했습니다.
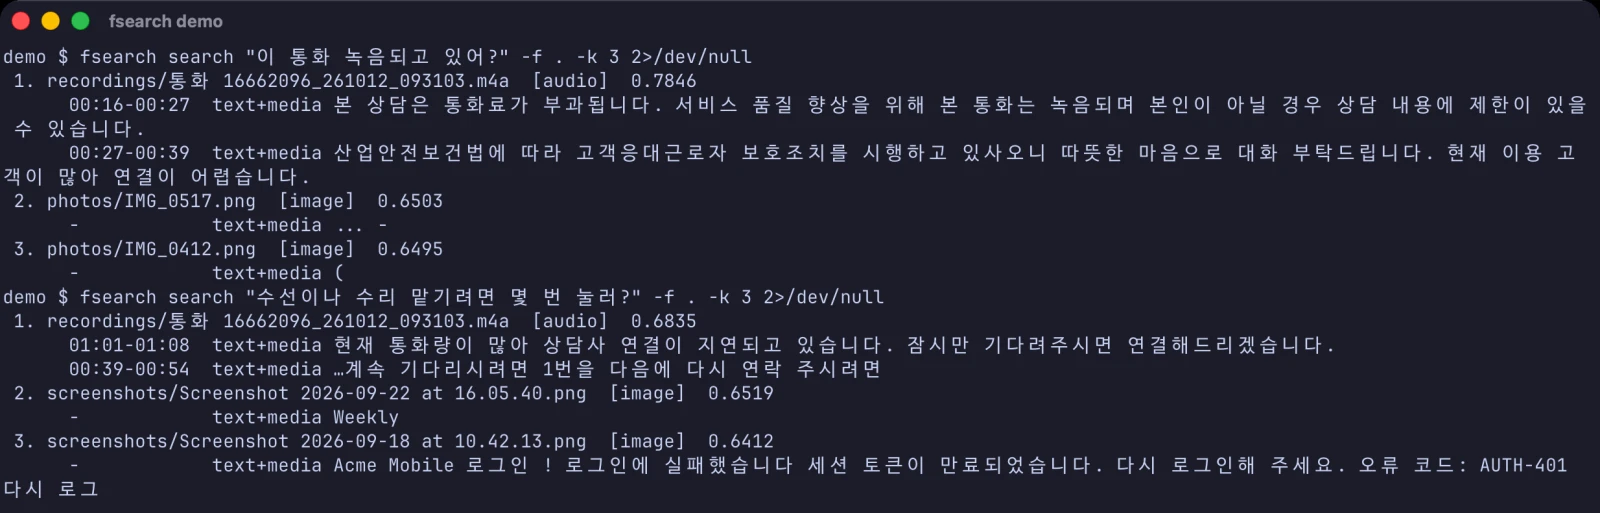
- 단위가 받아쓰기 문장 기준으로 다시 나뉘었습니다(15초 구간 9개 → 문장 묶음 7개). 바뀐 파일 하나만 다시 색인했습니다.
- "녹음되고 있어?"는 "본 통화는 녹음되며"라고 말한 구간(
00:16-00:27)을 정확히 가리키고 그 문장을 보여 줍니다. 점수도 0.7147에서 0.7846으로 올랐습니다. - "수선이나 수리 맡기려면 몇 번 눌러?"는 받아쓰기를 넣어도 못 맞혔습니다. 답은 "AS 관련 문의는 2번"(00:11 무렵)인데, 1위 구간은 대기 안내(
01:01-01:08)였고 "1번을"이 나오는 구간이 2위였습니다. 원인은 확인하지 못했지만 질의의 "수선·수리"와 받아쓰기의 "AS"처럼 표현이 다른 점이 영향을 줬을 가능성이 있습니다.
두 질의의 결과를 받아쓰기 전후로 한 시간축에 놓으면 이렇습니다.
6. 텍스트 임베딩 + OCR 파이프라인과 비교
6-1. 비교 방법
멀티모달 임베딩이 실제로 나은지 확인하려고 흔히 쓰는 "텍스트 임베딩 모델 + OCR + 받아쓰기"와 같은 질의로 비교했습니다. 비교에는 5장의 시연 녹음을 가져온 개인 자료 폴더를 썼습니다. 스크린샷 5장, 녹음 1개(시연의 그 녹음, 받아쓰기 있음), 스캔 PDF, 글자 PDF, docx·pptx가 섞인 248단위입니다.
| 방식 | 단위의 글자 | 벡터 |
|---|---|---|
| bge-m3 +OCR | 추출한 글자. 글자 없는 이미지·쪽은 OCR 글자, 녹음은 받아쓰기 | BAAI/bge-m3 텍스트 벡터 |
| Qwen3-0.6B +OCR | 위와 같음 | Qwen3-Embedding-0.6B(GGUF Q8_0) 텍스트 벡터 |
| Gemma 텍스트만 +OCR | 위와 같음 | EmbeddingGemma 2 텍스트 벡터 |
| Gemma 멀티모달 | OCR 없이 추출한 글자와 받아쓰기 | 텍스트 벡터와 media 벡터 중 큰 값 |
| Gemma 멀티모달 +OCR | 위에 OCR 글자를 더함 (지금 fsearch의 색인 방식, 순위 보정 전) | 텍스트 벡터와 media 벡터 중 큰 값 |
질의마다 찾을 파일을 정해 두고 그 파일이 1위인 질의 수와 3위 안인 질의 수를 셌습니다. 파일 점수는 그 파일의 단위 점수 중 최고입니다.
6-2. 비교 결과
방식에 따라 차이가 가장 크게 난 것은 스크린샷 질의였습니다.
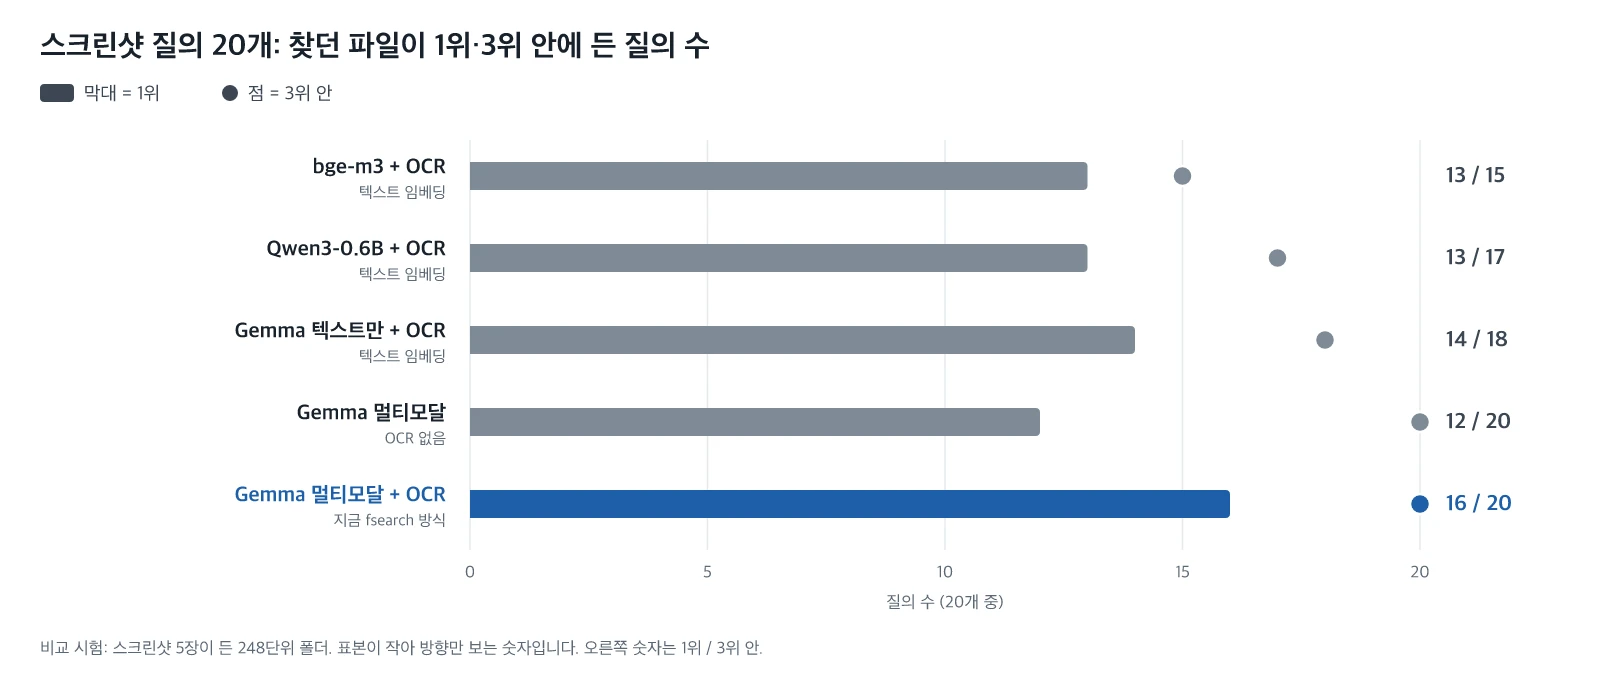
아래 표는 분류별 전체 결과입니다. 각 칸은 1위 / 3위 안 질의 수입니다.
| 분류 (질의 수) | bge-m3 +OCR | Qwen3-0.6B +OCR | Gemma 텍스트만 +OCR | Gemma 멀티모달 | Gemma 멀티모달 +OCR |
|---|---|---|---|---|---|
| 스크린샷 (20) | 13 / 15 | 13 / 17 | 14 / 18 | 12 / 20 | 16 / 20 |
| 녹음, 받아쓰기 있음 (30) | 23 / 28 | 25 / 27 | 28 / 29 | 27 / 29 | 28 / 29 |
| 글자 PDF·깨진 글자 PDF (12) | 12 / 12 | 12 / 12 | 12 / 12 | 12 / 12 | 12 / 12 |
| docx·pptx (20) | 18 / 20 | 19 / 20 | 19 / 19 | 19 / 19 | 19 / 19 |
| 정확 일치 질의 (15) | 9 / 10 | 10 / 11 | 9 / 9 | 7 / 8 | 9 / 9 |
6-3. 비교에서 얻은 결론
- 스크린샷은 OCR 글자와 그림 벡터가 서로 다른 질의를 맞혔습니다. 글자만 쓰면 1위가 많고(14), OCR 없이 그림 벡터를 쓰면 3위 안이 많았습니다(20). 둘을 함께 쓴 것이 16 / 20으로 가장 좋았습니다.
- 녹음은 받아쓰기의 몫이 컸습니다. 받아쓰기 글자만 쓴 것(28 / 29)과 소리 벡터를 더한 것이 거의 같았습니다. 소리 벡터는 받아쓰기가 없을 때의 보조입니다.
- 글자가 잘 뽑히는 문서는 어느 방식이든 거의 같았습니다. 이번 표본에서는 텍스트만 다룬다면 이 모델로 바꿀 이유가 적었습니다. 텍스트 모델로만 비교하면 EmbeddingGemma 2는 녹음 질의 1위가 가장 많았지만(28, bge-m3 23, Qwen3 25), docx·pptx 3위 안(19 대 20)과 정확 일치 질의(Qwen3 10 / 11)에서는 비교 모델이 조금 나았습니다.
- 그 대신 색인 시간이 더 듭니다. 글자 임베딩만 봐도 bge-m3보다 1.5배 느렸고, 그림·소리로 media 벡터를 만드는 시간이 따로 더 들었습니다(아래 표).
| 임베딩 | 단위 수 | 시간 |
|---|---|---|
| bge-m3, 글자 | 248 | 25.9초 |
| EmbeddingGemma 2, 글자 | 248 | 39.1초 |
| EmbeddingGemma 2, 그림·소리(media) | 147 | 51.1초 |
| EmbeddingGemma 2 합계 | 90.2초 |
모델을 미리 올려 두고 임베딩 시간만 잰 값입니다. 파일 읽기·OCR을 포함한 전체 색인 시간은 아닙니다.
표본이 작습니다
질의는 내용을 보고 만든 것이고 샘플이 작습니다(이미지 5장, 녹음 1개). 숫자는 방향을 보는 정도로 읽어 주세요.
7. 실제 노트 폴더 4,497개에서 순위 보정하기
7-1. 큰 폴더에서 생긴 문제
마지막으로 실제로 쓰는 노트 폴더의 사본(1.6GB, 파일 4,497개: 텍스트 3,181, 이미지 1,034, PDF 44, 녹음 47, 동영상 8 등)을 색인했습니다. 첫 색인은 약 104분이 걸렸고 27개가 실패했습니다. 원인을 고쳐 다시 돌린 뒤(약 50분) 23,163단위가 되었습니다. 파일 내용을 읽고 질의 42개를 만들어 재 보니 19개가 1위, 35개가 10위 안이었습니다.
그런데 이미지·동영상이 같은 주제의 노트에 밀렸습니다. 작은 시험 폴더에서는 이미지 질의가 모두 1위였는데 단위가 70배 넘게 많은 큰 사본에서는 비슷한 노트가 위를 채웠습니다. 질의마다 정답 형식으로 좁히면(-t image, -t video, -t audio) 미디어 질의 17개 중 10개가 1위였습니다. 다른 형식과 한 줄로 섞이는 것이 큰 원인으로 보였습니다.
7-2. 넣은 보정 두 가지
순위 방식을 몇 가지 비교한 뒤 두 가지를 넣었습니다.
- media 유사도에 0.02를 더합니다. 0.04부터 문서 질의 성적이 떨어지기 시작했습니다.
- 형식별 1위를 넣습니다. 결과 안에 이미지·동영상·녹음이 하나도 없으면 빠진 형식의 1위 파일을 최대
k // 3개까지 결과 뒤쪽 자리에 "(형식별 1위)"로 넣습니다. 앞 순위는 바꾸지 않습니다.k가 3보다 작거나,-t로 형식을 정하거나,-e를 쓰면 넣지 않습니다.
7-3. 보정 결과
| 방식 | 10위 안 (질의 42개) |
|---|---|
| 보정 전 | 35 |
| media +0.02만 | 37 |
| 형식별 1위만 | 37 |
| 둘 다 | 39 |
비교 도구로 따로 잰 값입니다. 실제 검색으로 다시 재도 1위 20개, 10위 안 39개였습니다. 문서 질의 25개는 1위·10위 안에 든 개수가 그대로였습니다(1위와 2위가 서로 바뀐 질의 두 개는 있었습니다).
0.02는 이 질의 42개를 보고 고른 값이라 다른 폴더에서도 같을지는 모릅니다.
8. 시행착오 – 오류 없이 조용히 틀리는 입력 처리
만들면서 입력 처리에서 몇 번 걸렸습니다. 8-1, 8-2, 8-4는 오류 없이 조용히 틀리는 종류였고 8-3은 오류를 내며 실패했습니다.
8-1. .m4a 경로를 넘기면 텍스트로 임베딩된다
핸드폰 음성 메모나 통화 녹음으로 생기는 .m4a 파일의 경로를 넘기면 텍스트로 임베딩됩니다. sentence-transformers는 경로가 .mp3·.wav·.ogg·.flac·.aac로 끝날 때만 오디오로 봅니다. .m4a는 경로 문자열이 그대로 임베딩됩니다. 그래서 모든 오디오를 ffmpeg로 모노 16kHz 배열로 바꿔 넘깁니다.
8-2. 투명 배경 PNG가 검은 그림이 된다
Image.convert("RGB")는 투명도를 버려서 시험한 투명 아이콘 두 개가 검은 그림이 되었습니다. 두 아이콘의 유사도가 소수점 넷째 자리까지 같아서 알았습니다. 흰 바탕에 합성한 뒤 넘깁니다.
8-3. 본문에 <|image|> 글자가 있으면 실패한다
이 모델은 글과 그림을 섞은 입력을 받을 때 그림 자리를 <|image|>로 표시합니다. 그래서 본문에 이 글자가 그대로 있으면 그림 자리 표시로 읽고 함께 넘긴 그림이 없으니 오류가 납니다. 모델 입력 형식을 적어 둔 노트 두 개가 "이미지가 없다"는 오류를 냈습니다. 문서와 질의에서 <|image|>·<|video|>·<|audio|>를 보통 글자로 바꿉니다.
8-4. macOS 한글 파일 이름의 NFC·NFD
macOS에서는 똑같아 보이는 한글 파일 이름이 서로 다른 문자열일 수 있습니다. 한글은 "한"을 글자 하나로 저장하는 방식(NFC)과 ㅎ·ㅏ·ㄴ 자모로 나눠 저장하는 방식(NFD)이 있고 화면에는 똑같이 보입니다. macOS 디스크에서 읽은 파일 이름은 NFD일 때가 있어서 색인에 저장한 이름(NFC)과 비교하면 다른 이름으로 나옵니다.
평가 스크립트가 이 때문에 한글 이름 파일 5개를 정답과 맞추지 못해 점수가 실제보다 낮게 나왔습니다. 그래서 파일 이름을 비교하기 전에는 늘 unicodedata.normalize("NFC", name)으로 맞추고 녹음과 받아쓰기 파일을 이름으로 짝지을 때도 같은 처리를 합니다.
8-5. 동영상 입력은 화면만 쓴다
모델 카드에 따르면 동영상은 1초에 1프레임씩 뽑아 비전 인코더로 읽습니다. 소리는 들어가지 않아서 소리 트랙이 있는 영상과 없는 영상의 벡터가 똑같았습니다. 소리까지 반영하려면 소리를 따로 꺼내 오디오 입력으로 함께 넣어야 합니다.
또 동영상 파일 경로를 그대로 넘기면(torchcodec 필요) 처리기 기본값(max_frames: 32) 때문에 영상 길이와 상관없이 최대 32프레임만 고르게 뽑습니다. 그래서 fsearch는 30초가 넘는 영상을 ffmpeg로 30초씩 소리를 뺀 1fps 클립으로 잘라 넘기고 구간마다 벡터를 하나씩 만듭니다. 30초 이하 영상은 원본 경로를 그대로 넘깁니다. 영상 속 대화는 지금은 검색에 쓰지 않습니다. 나중에 STT로 대화를 받아써서 구간마다 붙일 예정입니다.
9. 장점과 한계, 어디에 쓰면 좋을까
9-1. 장점
- 모델 하나, 컬렉션 하나로 노트·문서·스크린샷·사진·녹음·동영상을 같은 질의로 찾습니다. 형식마다 검색기를 따로 만들 필요가 없습니다. 다만 큰 폴더에서는 작은 순위 보정이 필요했습니다.
- 글자가 없는 사진도 내용으로 찾습니다(시연의 고양이·화이트보드).
- 이름이 의미 없는 스캔 PDF도 찾습니다. 시험 폴더의 PDF 이름을
doc-01.pdf처럼 바꾸고 다시 재 보니, OCR 없이 추출한 글자만 쓰는 방식은 스캔본 질의 2개 중 1위가 1개에서 0개가 되었습니다(글자가 없어 파일 이름만 남기 때문). 쪽 그림 벡터로는 두 질의 모두 그대로 1위였습니다. - 임베딩은 이 컴퓨터에서, 색인은 직접 운영하는 서버에서 돌아갑니다. 파일 내용을 외부 서비스로 보내는 단계가 fsearch에는 없습니다(이 글의 녹음 받아쓰기는 별도 자동화가 Mistral API로 만든 것입니다).
- 결과에 파일과 함께 위치(쪽, 슬라이드, 녹음 구간)까지 나옵니다.
9-2. 한계
- 이번 비교에서 글자가 잘 뽑히는 문서는 이점이 거의 없었습니다. 색인은 오히려 느립니다.
- 녹음 검색은 받아쓰기에 크게 기댑니다. 받아쓰기가 없으면 녹음에 나온 말을 그대로 쓴 질의는 대체로 찾지만(한국어 4개 중 4개, 영어 4개 중 2개), 상관없는 질의에도 높은 점수로 올라오고 위치도 틀릴 때가 있습니다. 받아쓰기가 있어도 "수리"와 "AS"처럼 다른 말로 같은 뜻을 묻는 질의는 놓쳤습니다.
- 큰 폴더에서는 이미지·동영상이 노트에 밀렸습니다. 순위 보정이 필요했고 보정값은 제 질의로 고른 것입니다.
- 이 모델은 질의와 문서를 따로 벡터로 만드는 바이인코더(bi-encoder)입니다. 이 모델로는 리랭크(rerank)를 할 수 없습니다. 리랭크는 질의와 후보를 함께 읽고 다시 점수를 매기는 방식입니다. 정밀도를 더 올리려면 별도의 멀티모달 리랭커(reranker)를 붙이는 방법이 있습니다.
- 큰 폴더는 첫 색인이 깁니다. 파일 4,497개 폴더에서 첫 실행이 약 104분이었습니다. 그다음부터는 바뀐 파일만 색인합니다.
- 모델이 공개된 지 1~2주라(2026-10-13 조사 기준) 다른 사람의 사용 후기를 많이 찾지 못했습니다.
9-3. 어디에 쓰면 좋을까
결과를 보고 든 의견입니다. 마지막 두 가지는 이번에 시험하지 않은 것이고 시험 규모도 작아서 직접 시험해 보고 고르기를 권합니다.
| 용도 | 이유 |
|---|---|
| 스크린샷과 사진이 많은 개인 자료 폴더 | 이번 시험에서 이 모델이 가장 값을 한 곳입니다. 화면을 캡처해 두고 이름은 붙이지 않는 습관이 있다면 먼저 시험해 볼 만합니다 |
| 회의 녹음 보관함 | 음성 인식으로 받아쓰기를 함께 두는 것이 전제입니다. 그러면 녹음 파일뿐 아니라 그 이야기를 한 구간까지 찾을 수 있습니다 |
| 스캔 문서가 섞인 문서함 | 견적서, 계약서 스캔처럼 이름이 번호뿐인 파일을 OCR과 쪽 그림 벡터로 함께 찾습니다 |
| 디자인·UI 캡처 모음 (미시험) | 그림 벡터가 있으니 "빨간 경고 아이콘이 있는 로그인 화면"처럼 생김새로 찾는 질의도 해 볼 만합니다 |
| 인터넷이 안 되는 곳의 RAG 1차 검색 (미시험) | 모델과 패키지를 미리 받아 두고 내부망의 Weaviate를 쓰면, 인터넷 없이도 이미지·오디오가 섞인 자료를 한 번에 후보로 모을 수 있습니다 |
반대로 텍스트 위키나 코드 검색은 기존 텍스트 임베딩과 키워드 검색으로 충분할 가능성이 높습니다. 고를 때는 폴더에 글자가 없는 파일이 얼마나 되는지를 보면 됩니다.
자주 묻는 질문
EmbeddingGemma 2는 무료로 쓸 수 있나요?
모델 카드 기준 라이선스는 Apache 2.0입니다. 이 글에서는 Hugging Face 로그인 없이 google/embeddinggemma-2를 내려받았고(처음 약 1.5GB), 임베딩은 모두 내 컴퓨터에서 계산했습니다.
멀티모달 임베딩이 텍스트 임베딩 + OCR보다 항상 낫나요?
아닙니다. 이번 비교에서 스크린샷은 그림 벡터와 OCR 글자를 함께 쓴 방식이 16 / 20으로 가장 좋았습니다. 하지만 글자가 잘 뽑히는 PDF·docx·pptx에서는 기존 텍스트 임베딩 모델과 차이가 거의 없었습니다. 자세한 숫자는 비교 결과에 있습니다.
녹음 파일도 받아쓰기 없이 찾을 수 있나요?
녹음에 나온 말을 그대로 쓴 질의는 대체로 찾았습니다. 이번에는 한국어 4개 중 4개, 영어 4개 중 2개였습니다. 다만 상관없는 질의에도 녹음이 높은 점수로 올라왔습니다. 가리키는 구간이 틀릴 때도 있었습니다. 받아쓰기를 붙이자 구간을 정확히 가리키고 점수도 올랐습니다(받아쓰기 연결 결과).
.m4a 녹음을 넣었는데 이상한 결과가 나와요
sentence-transformers는 .mp3·.wav·.ogg·.flac·.aac 경로만 오디오로 봅니다. .m4a 경로를 그대로 넘기면 경로 문자열이 텍스트로 임베딩됩니다. ffmpeg로 모노 16kHz 배열로 바꿔 넘기세요(시행착오 8-1).
벡터 차원을 줄여서 저장 공간을 아껴도 되나요?
MRL로 학습해서 768차원을 512·256·128로 잘라 쓸 수 있습니다. 자른 뒤에는 다시 L2 정규화하고 질의와 문서 차원을 맞춰야 합니다. 모델 카드 점수로는 256차원에서 멀티모달 점수가 59.01 → 56.24로 조금, 128차원에서는 45.65로 크게 떨어집니다. fsearch는 768차원을 그대로 썼습니다.
파일 내용이 외부로 나가나요?
fsearch에서는 나가지 않습니다. 임베딩은 내 컴퓨터에서 계산합니다. 추출한 글자와 벡터는 직접 운영하는 Weaviate 서버에 둡니다. 다만 이 글의 녹음 받아쓰기는 별도 자동화가 Mistral API의 Voxtral로 만든 것입니다.
마무리
해 본 일을 짧게 돌아보면 이렇습니다.
- EmbeddingGemma 2를
float32로 불러와 텍스트·이미지·오디오를 같은 768차원 공간의 벡터로 만들었습니다. - 파일은 쪽·슬라이드·녹음 구간 같은 단위로 나눴습니다. Weaviate 객체 하나에는
text·media벡터 두 개를 붙였습니다. - 검색할 때는 두 벡터로 각각 찾아 큰 값을 단위 점수로 썼습니다. BM25는 순위에 섞지 않고 키워드 일치 덧붙이기와 정확 일치 모드에만 썼습니다.
- 글자 없는 사진, 이름이 번호뿐인 스캔 PDF, 화이트보드 사진은 시연 폴더에서 모두 1위였습니다. 녹음은 받아쓰기를 붙여야 구간을 정확히 가리켰습니다.
- 텍스트 임베딩 + OCR과 비교해 보니 스크린샷에서는 이점이 있었습니다. 글자가 잘 뽑히는 문서는 차이가 거의 없었습니다.
- 큰 폴더(파일 4,497개)에서는 이미지·동영상이 노트에 밀렸습니다. media +0.02와 형식별 1위 넣기로 보정해 10위 안이 35개에서 39개가 되었습니다.
다음에는 이런 것을 해 볼 만합니다.
- 동영상 속 대화를 STT로 받아써서 구간마다 붙이기
- 멀티모달 리랭커를 붙여 정밀도 올리기
- 디자인·UI 캡처 모음처럼 생김새로 찾는 질의를 직접 시험해 보기
함께 보면 좋은 글
이전에 LLaVA와 벡터 DB로 만든 이미지 검색, 로컬 LLM과 무료 API 사용법은 아래 글에 정리했습니다.
- Ollama #5: LLaVA모델과 벡터DB를 활용한 멀티모달 스마트 이미지 검색 시스템
- Ollama #1: 비용 걱정 없이 내 컴퓨터에서 제약 없는 LLM 실행하기
- NVIDIA NIM 무료 API 사용법 – 가입부터 챗봇·n8n 연동·모델 비교까지